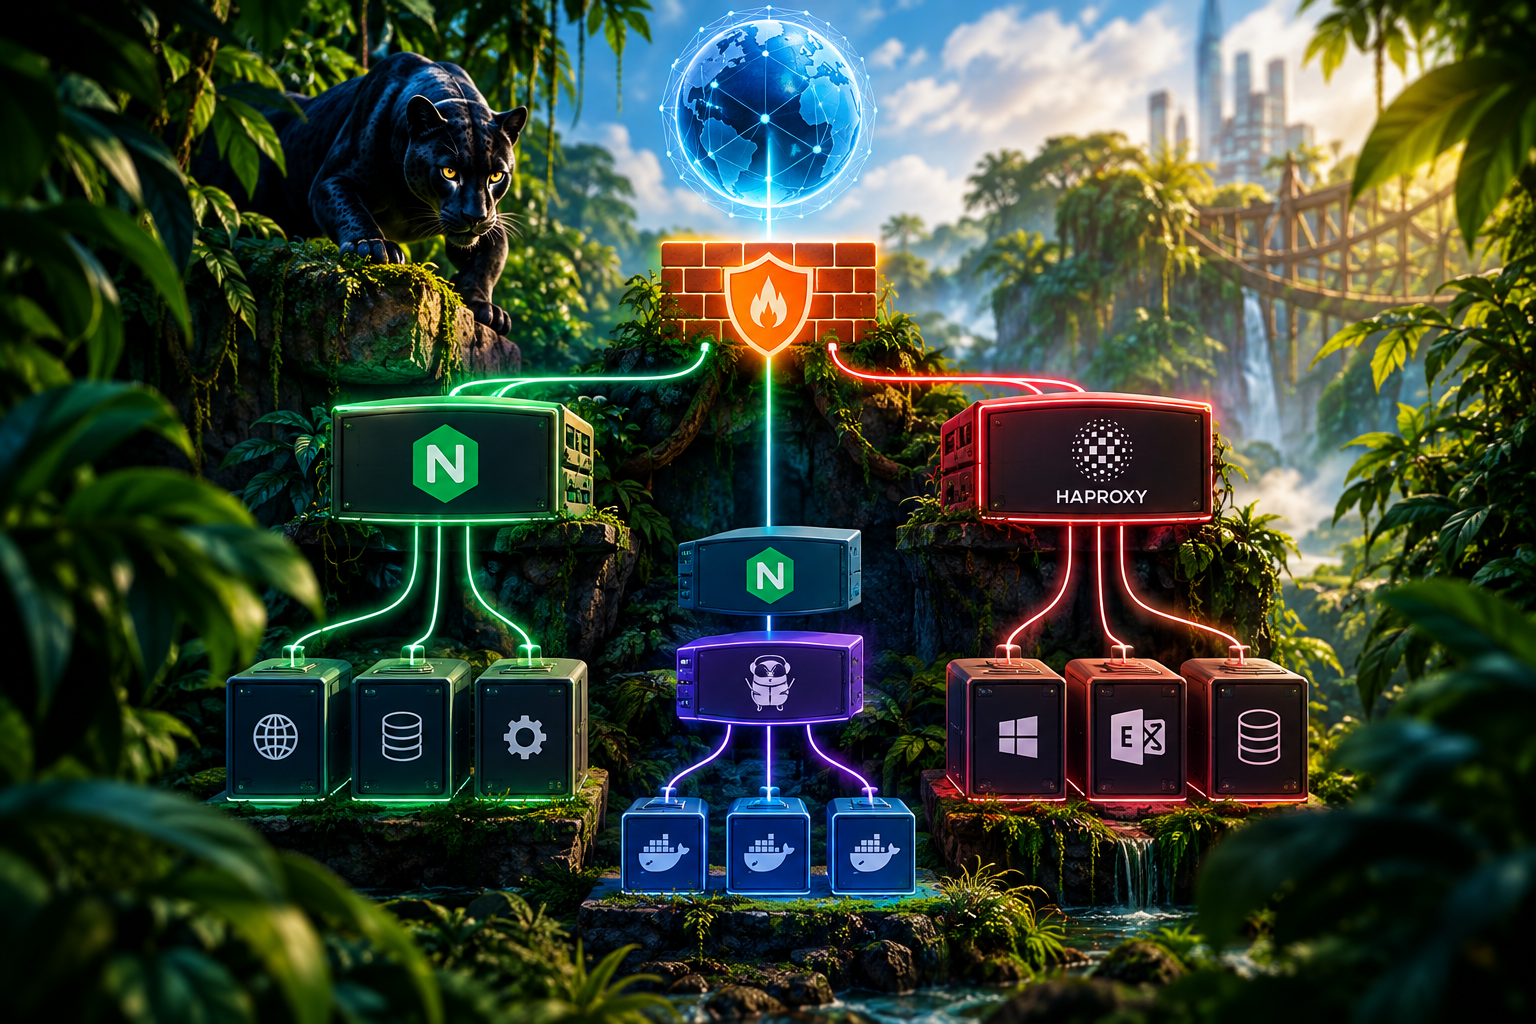
Dans cet article, je vais vous présenter les différents reverse proxy que j’utilise dans mes environnements professionnels, mais surtout pour quelles utilisations je les choisis.
Car en 2026, le choix d’un reverse proxy ne se résume plus à la question « Nginx ou Apache ? ».
Entre les serveurs Web historiques, les reverse proxy spécialisés, les solutions packagées, les API gateways, les ingress controllers Kubernetes et les appliances ADC, l’offre est devenue particulièrement importante.
Et contrairement à ce que l’on pourrait penser, je n’utilise pas une seule solution partout.
Bienvenue dans la jungle des reverse proxy.
Sommaire
Qu’est-ce qu’un reverse proxy ?
Pour faire simple, un reverse proxy est un serveur placé en frontal d’un ou plusieurs serveurs Web ou applications.
Le client se connecte au reverse proxy, qui va ensuite transmettre la requête au serveur applicatif concerné.
On obtient donc quelque chose de ce type :
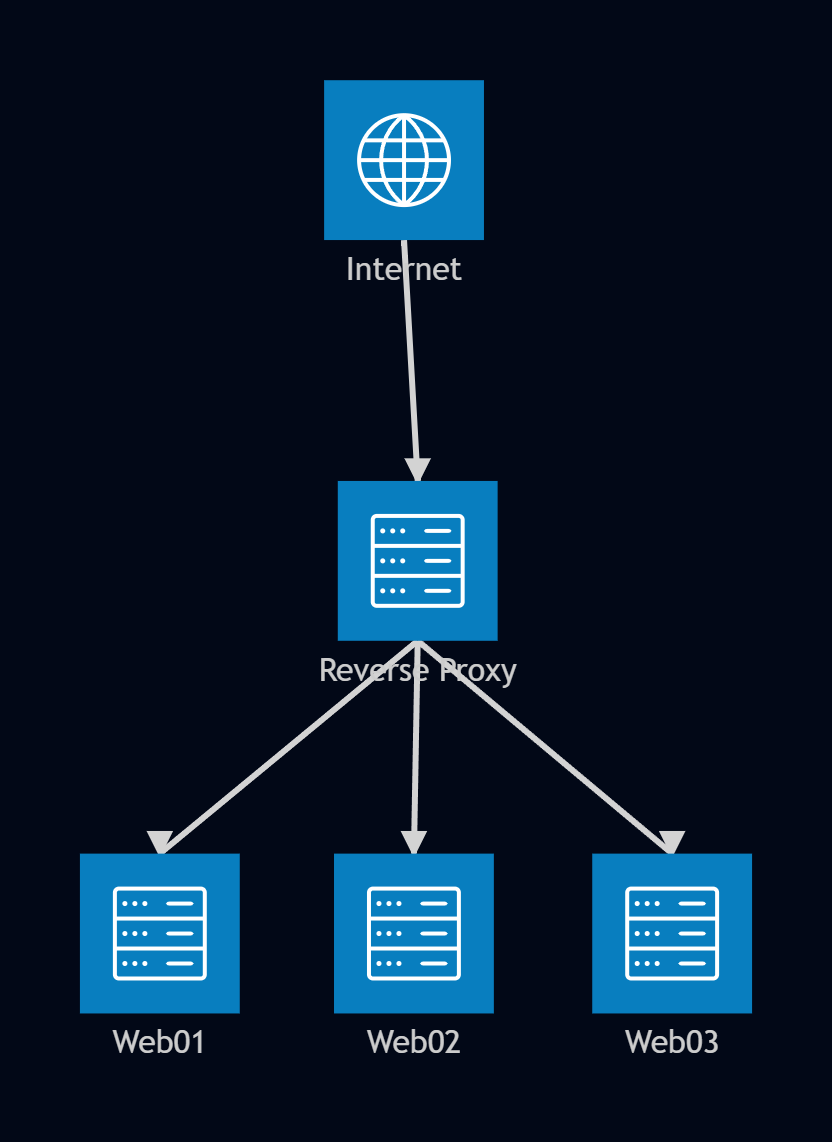
Historiquement, l’un des principaux intérêts du reverse proxy était de mutualiser une adresse IP publique.
Avec une seule adresse IP, il est possible de publier plusieurs sites ou applications hébergés sur différents serveurs.
Le reverse proxy reçoit les requêtes HTTP/HTTPS et, grâce notamment au nom d’hôte demandé par le client, sait vers quel serveur transmettre la requête.
Par exemple :
https://www.site-a.fr   ---> Web01
https://www.site-b.fr   ---> Web02
https://application.fr  ---> Web03
C’est évidemment une vision très simplifiée du reverse proxy.
Car au fil des années, son rôle s’est considérablement élargi.
Où se trouve le reverse proxy dans l’architecture ?
Dans une architecture professionnelle classique, le reverse proxy n’est généralement pas directement exposé à Internet.
Il est placé derrière un pare-feu périmétrique, qui va notamment contrôler les flux entrants et publier les ports nécessaires vers le reverse proxy.
On retrouve généralement une architecture de ce type :
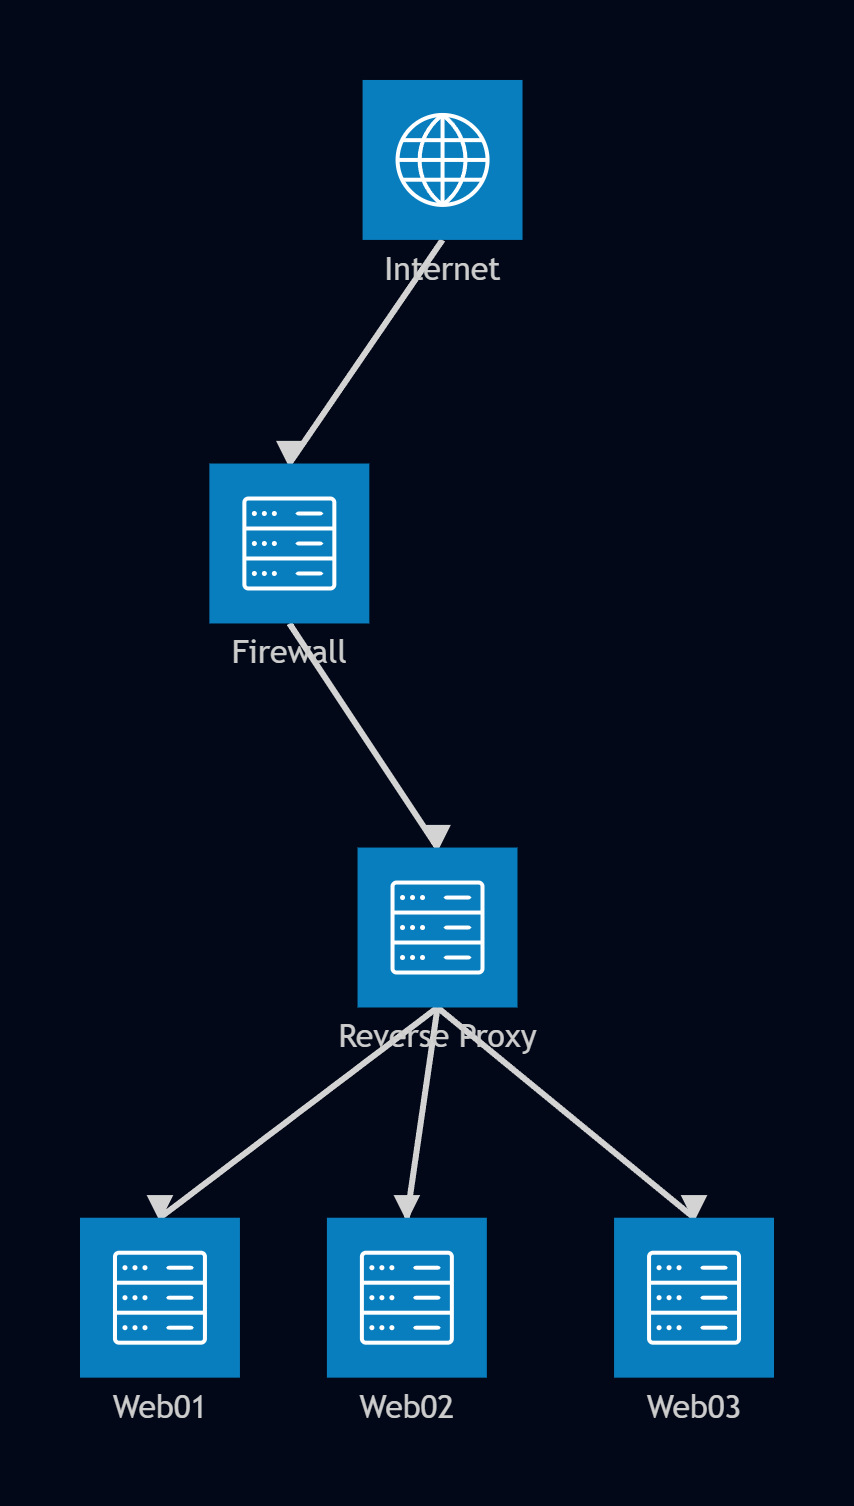
Le firewall reste donc le premier point de contrôle réseau en frontal.
Le reverse proxy intervient ensuite au niveau de la publication des applications et des flux Web.
Il est important de faire cette distinction : un reverse proxy ne remplace pas un firewall.
Dans mon environnement, Nginx et HAProxy sont tous les deux utilisés comme frontaux Internet, mais pour des besoins différents.
Nginx prend en charge la grande majorité des publications Web, tandis que HAProxy est utilisé pour certains besoins spécifiques, notamment lorsque je souhaite conserver un flux TCP/SSL de bout en bout.
Pour les services internes, notamment ceux hébergés sur Docker, l’architecture est différente :
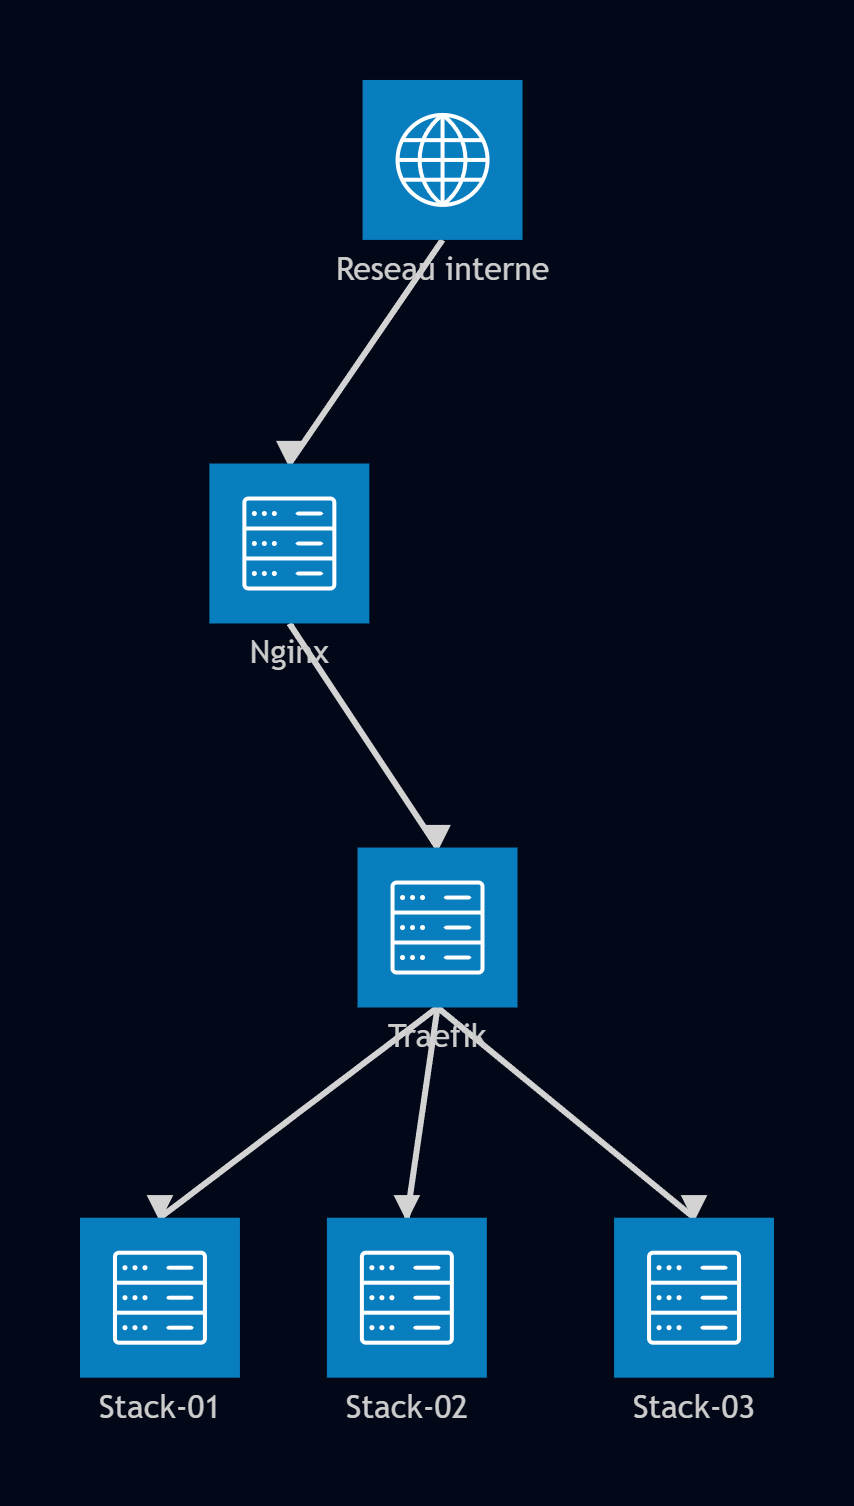
Cette séparation entre les usages est importante, car elle explique pourquoi je peux utiliser plusieurs reverse proxy dans une même infrastructure.
L’évolution des reverse proxy
À l’origine, le reverse proxy servait principalement à publier plusieurs applications derrière une même adresse IP.
Puis de nouvelles fonctionnalités sont apparues.
Load Balancing
Le reverse proxy peut notamment prendre en charge la répartition de charge, ou Load Balancing.
Au lieu d’avoir un seul serveur derrière une application, plusieurs serveurs peuvent répondre aux requêtes :
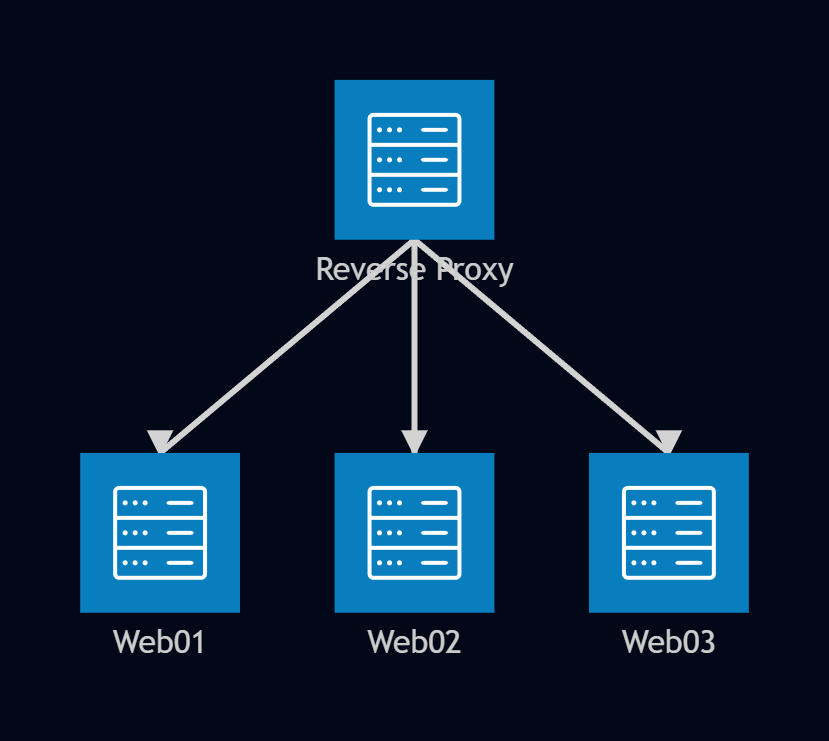
Le reverse proxy peut alors répartir les requêtes entre les différents serveurs.
L’objectif est double :
- améliorer la capacité de traitement ;
- permettre la haute disponibilité du service.
Si un serveur devient indisponible, le reverse proxy peut également cesser de lui envoyer du trafic.
Le reverse proxy devient alors un composant important dans les architectures HA, avec différentes méthodes de répartition et de détection de l’état des serveurs.
L’arrivée massive du HTTPS
Avec la généralisation du HTTPS, le reverse proxy est également devenu un emplacement particulièrement intéressant pour gérer les certificats.
Avant la généralisation du HTTPS, la situation était évidemment beaucoup plus simple.
Puis, lorsque les sites et applications ont commencé à être massivement publiés en HTTPS, le reverse proxy a souvent été utilisé pour réaliser la terminaison TLS.
On pouvait alors avoir une architecture de ce type :
Client - HTTPS -> Reverse Proxy - HTTP -> Serveur WebLe reverse proxy réalisait alors la terminaison TLS, également appelée SSL Offloading.
Cela permettait notamment de centraliser la gestion des certificats.
Aujourd’hui, cette architecture est encore possible, mais dans un environnement professionnel, je privilégie autant que possible le chiffrement de bout en bout.
On obtient alors plutôt :
Client - HTTPS -> Reverse Proxy - HTTPS -> Serveur WebLe certificat utilisé par le serveur backend peut être différent de celui présenté par le reverse proxy : certificat public en frontal et certificat interne, voire émis par une PKI interne, sur le backend.
Le reverse proxy devient alors un point de terminaison TLS tout en conservant un flux chiffré jusqu’à l’application.
Le reverse proxy devient également un élément de sécurité
Le reverse proxy étant devenu la porte d’entrée principale vers les applications, il était assez logique de lui ajouter des fonctions de sécurité.
On retrouve notamment :
- WAF ;
- filtrage HTTP ;
- GeoIP ;
- limitation du nombre de requêtes ;
- blocage d’adresses IP ;
- modification des headers HTTP ;
- contrôle des méthodes HTTP ;
- authentification ;
- contrôle des tailles de requêtes ;
- protection contre certaines attaques applicatives.
Des solutions comme ModSecurity, avec les règles OWASP CRS, permettent par exemple de transformer un reverse proxy classique en véritable point de contrôle de sécurité applicative.
Le reverse proxy peut donc devenir une véritable couche intermédiaire entre Internet et l’application.
Et maintenant les conteneurs
L’arrivée massive de Docker puis de Kubernetes a encore changé la donne.
Dans une architecture traditionnelle, on peut relativement facilement configurer manuellement son reverse proxy :
Internet
     |
Nginx
     |
    +--- Serveur Web
    +--- Application
    +--- API
Avec Docker et Kubernetes, les applications apparaissent et disparaissent beaucoup plus fréquemment.
Les adresses IP peuvent changer, les services sont dynamiques et les déploiements sont automatisés.
Il devient donc intéressant que le reverse proxy puisse découvrir automatiquement les services.
C’est notamment l’une des raisons du succès de solutions comme Traefik et des différents ingress controllers Kubernetes.
Dans Docker Compose, par exemple, Traefik peut utiliser les labels pour savoir comment publier un conteneur :
Docker
     |
    +--- WordPress
     |
    +--- Nextcloud
     |
    +--- Grafana
    |
    +--- Traefik
Le reverse proxy devient alors une partie intégrante de l’infrastructure automatisée.
Les reverse proxy disponibles en 2026
Il faut toutefois faire attention lorsque l’on parle de « reverse proxy ».
Toutes les solutions que l’on trouve aujourd’hui ne jouent pas exactement le même rôle.
Je distinguerais plusieurs grandes familles.
Les serveurs et reverse proxy historiques
On retrouve notamment :
- Nginx
- Apache HTTP Server
- HAProxy
- Caddy
- IIS avec ARR
À cette liste, on peut également ajouter Envoy, qui occupe aujourd’hui une place importante dans les architectures modernes, notamment autour de Kubernetes et des architectures distribuées.
Les appliances ADC
Dans le monde professionnel, on trouve également les solutions dites Application Delivery Controller (ADC).
Par exemple :
- F5 BIG-IP ;
- Citrix ADC / NetScaler ;
- A10 ;
- Kemp / LoadMaster.
Ces solutions vont généralement bien au-delà du simple reverse proxy avec des fonctions de Load Balancing, TLS, sécurité, haute disponibilité, gestion applicative, etc.
Les solutions packagées
On trouve ensuite des solutions qui fournissent une expérience plus complète autour d’un moteur de reverse proxy.
Par exemple :
- Nginx Proxy Manager ;
- OpenResty ;
- BunkerWeb ;
- SafeLine.
Certaines de ces solutions ajoutent notamment une interface graphique, la gestion des certificats, des fonctions de sécurité ou une simplification de la configuration.
Les API gateways
Il existe également une autre catégorie qui peut se retrouver devant les applications :
- Kong ;
- Apache APISIX ;
- Tyk ;
- Traefik.
Leur objectif est davantage orienté vers la gestion des API : authentification, routage, quotas, transformation des requêtes, observabilité, etc.
Et Kubernetes ?
Enfin, Kubernetes a fait émerger une autre catégorie : les Ingress Controllers et, plus récemment, les solutions basées sur la Gateway API.
On retrouve notamment :
- NGINX Ingress Controller ;
- Traefik ;
- HAProxy ;
- Envoy Gateway ;
- Istio et son écosystème Envoy.
Même si ces solutions utilisent souvent un reverse proxy comme moteur, leur mode de fonctionnement et leur intégration avec Kubernetes les rendent assez différentes d’un Nginx configuré manuellement.
Et le WAF dans tout ça ?
Le WAF est souvent associé au reverse proxy, mais ce sont bien deux fonctions différentes.
Le reverse proxy s’occupe principalement de recevoir et de transmettre les requêtes.
Le WAF va, lui, analyser le contenu de ces requêtes afin de détecter des comportements ou des attaques applicatives.
Dans le monde open source, ModSecurity reste une solution très connue, notamment avec l’OWASP Core Rule Set.
On voit également apparaître Coraza, notamment dans les environnements modernes et autour de solutions cloud-native.
L’intérêt d’intégrer le WAF directement au frontal est assez évident : le trafic peut être analysé avant même d’atteindre l’application.
Mais là encore, je ne considère pas le WAF comme obligatoire partout.
Une application publique, une API interne et une application publiée derrière un CDN ou un service de protection peuvent avoir des besoins très différents.
Quelles solutions est-ce que j’utilise ?
Maintenant que nous avons fait le tour de la jungle, passons à la partie qui m’intéresse réellement.
Qu’est-ce que j’utilise dans mes environnements professionnels ?
Pour commencer, je ne cherche pas à utiliser une seule solution partout.
Je choisis le reverse proxy en fonction du contexte, de l’application et surtout de la manière dont elle doit être publiée.
Mon architecture est donc plutôt constituée de plusieurs briques :
                              INTERNET
                                  |
                                  v
                         +----------------+
                         |    FIREWALL    |
                         |                |
                         +----------------+
                            |          |
                    +-------+          +-------+
                    |                          |
                    v                          v
             +-------------+             +-------------+
             |    NGINX    |             |   HAPROXY   |
             | HTTP/HTTPS  |             | TCP/Stream  |
             +-------------+             +-------------+
                    |                          |
                    v                          v
              Applications               Services MS
                                         Exchange / RDS
Et pour les applications internes et les conteneurs :
                         RÉSEAU INTERNE
                               |
                               v
                         +-----------+
                         |   NGINX   |
                         +-----------+
                               |
                               v
                         +-----------+
                         |  TRAEFIK  |
                         +-----------+
                           |   |   |
                           v   v   v
                         App App App
                         Docker containers
Ce fonctionnement me permet d’utiliser chaque solution là où elle correspond le mieux à mon besoin.
Nginx : mon frontal Internet
Pour les services directement exposés sur Internet, Nginx reste ma solution principale.
Dans mon cas, il représente environ 95 % de mes reverse proxy Internet.
Je l’utilise notamment avec ModSecurity pour ajouter une couche WAF sur les services qui en ont besoin.
Mais ce n’est pas uniquement parce que Nginx est performant ou populaire.
C’est surtout parce que je connais très bien son fonctionnement et que je peux exploiter sa configuration de manière extrêmement fine.
J’ai aujourd’hui plus de 60 applications publiées.
Et avec ce volume, les besoins deviennent parfois assez particuliers.
On ne se contente plus d’un simple :
server {
    location / {
        proxy_pass http://backend;
    }
}
Certaines applications nécessitent des règles spécifiques, des headers particuliers, des exclusions, des règles de réécriture ou des comportements différents selon les URL.
C’est justement dans ces situations que la flexibilité de Nginx devient intéressante.
Nginx et mon approche GitOps
Un autre élément important dans mon choix est mon approche de gestion de configuration.
Je préfère avoir ma configuration dans des fichiers, versionnés dans Git.
Cela me permet notamment de :
- historiser les modifications ;
- revenir en arrière ;
- relire les changements ;
- faire des modifications via Git ;
- automatiser les déploiements ;
- conserver une trace de la configuration ;
- reproduire plus facilement une configuration.
Dans mon environnement, j’utilise également Nginx Dashboard pour faciliter la gestion de cette configuration.
Ce fonctionnement correspond particulièrement bien à ma manière de travailler.
Je peux donc avoir quelque chose comme :
Git
 |
 +-- nginx/
 |    |
 |    +-- site01.conf
 |    +-- site02.conf
 |    +-- site03.conf
 |
 +-- modsecurity/
 |
 +-- scripts/
 |
 v
Déploiement
 |
 v
Nginx
Pour moi, c’est un point particulièrement important.
Je ne suis donc pas uniquement attaché à Nginx pour ses performances ou sa popularité : son modèle de configuration correspond à ma façon d’exploiter l’infrastructure.
HAProxy pour certains usages spécifiques
J’utilise également HAProxy, mais dans des cas beaucoup plus ciblés.
Notamment pour certains produits Microsoft et lorsque je dois travailler en mode TCP/Stream plutôt qu’en reverse proxy HTTP classique.
C’est particulièrement intéressant pour certaines architectures où l’application ou le protocole supporte mal une terminaison TLS au niveau du reverse proxy.
Dans ce cas, plutôt que de faire :
Client
  |
 HTTPS
  v
Reverse Proxy
  |
 HTTP
  v
Application
je peux conserver le flux TCP :
Client
  |
 TLS
  |
  v
HAProxy
  |
 TLS
  |
  v
Application
Le reverse proxy ne déchiffre alors pas nécessairement le trafic.
C’est notamment utile dans certains environnements Microsoft, par exemple autour d’Exchange ou de passerelles de bureau à distance.
HAProxy me permet également de répondre à certains besoins de répartition de charge sans nécessairement devoir traiter le trafic au niveau HTTP.
Traefik pour Docker
À l’intérieur de mes infrastructures, lorsque je travaille avec Docker, j’ai tendance à privilégier Traefik.
La raison principale est son intégration avec Docker.
Avec Docker Compose ou Docker Swarm, il est possible de déclarer une partie de la configuration directement au niveau des services grâce aux labels.
L’application peut ainsi porter avec elle une partie de sa configuration de publication.
Par exemple :
                 Traefik
                    |
        +-----------+-----------+
        |           |           |
        v           v           v
     App A       App B       App C
Cela correspond beaucoup mieux à une infrastructure dynamique que de devoir modifier manuellement une configuration Nginx à chaque déploiement.
Mais je n’utilise pas Traefik seul
Dans mon architecture, Traefik n’est pas nécessairement le frontal ultime.
J’aime conserver un Nginx en amont de Traefik, notamment pour les applications internes.
Cela me permet de conserver un point central pour certaines fonctions :
- gestion des certificats ;
- routage ;
- maintenance ;
- coupure temporaire d’une application ;
- règles communes ;
- gestion des accès.
On peut donc avoir :
                    Nginx
                      |
                      v
                   Traefik
                      |
          +-----------+-----------+
          |           |           |
          v           v           v
        Docker      Docker      Docker
Traefik s’occupe alors davantage de la partie dynamique liée aux conteneurs, tandis que Nginx reste le point de contrôle central.
IIS + ARR pour Exchange
Enfin, j’utilise également IIS avec Application Request Routing (ARR) dans certains environnements Microsoft.
Notamment pour gérer le Load Balancing devant Exchange.
Ce n’est évidemment pas la solution que je choisirais pour publier une application Docker moderne.
Mais dans un environnement Microsoft, utiliser une solution native de l’écosystème peut avoir beaucoup de sens.
C’est justement l’intérêt d’avoir plusieurs outils dans sa boîte.
Pourquoi Nginx et pas une autre solution ?
C’est probablement la question que vous vous posez maintenant.
Après tout, pourquoi ne pas utiliser BunkerWeb partout ?
Sur le papier, BunkerWeb pourrait tout à fait répondre à une grande partie de mes besoins.
J’ai d’ailleurs déjà testé cette solution et je la trouve particulièrement intéressante.
Si vous devez mettre en place un nouveau frontal et que BunkerWeb correspond à votre besoin, c’est une solution qu’il faut sérieusement considérer.
Mais dans mon cas, le problème est différent.
J’ai aujourd’hui un existant important.
Avec plus de 60 applications publiées, j’ai accumulé au fil du temps des configurations parfois assez particulières.
Certaines sont simples, d’autres beaucoup moins.
Et c’est justement là que Nginx conserve un avantage important pour moi : sa liberté de configuration.
J’ai déjà rencontré des situations où j’ai pu réaliser quelque chose avec Nginx que je n’avais pas réussi à reproduire simplement avec une solution plus abstraite.
Ce n’est pas nécessairement un défaut de ces solutions.
C’est simplement une conséquence de leur philosophie.
Plus une solution cherche à simplifier la configuration, plus elle va également chercher à encadrer les possibilités offertes à l’utilisateur.
Dans mon cas, j’ai parfois besoin de sortir des sentiers battus.
Et lorsqu’on possède plusieurs dizaines d’applications en production, pouvoir modifier précisément le comportement du reverse proxy peut devenir beaucoup plus important qu’une interface graphique agréable ou qu’une configuration particulièrement simple.
Plusieurs reverse proxy plutôt qu’un seul
Au final, ma philosophie est assez simple :
je ne cherche pas le meilleur reverse proxy.
Je cherche le reverse proxy adapté au besoin.
Pour résumer :
| Besoin | Solution que j’utilise |
|---|---|
| Frontal Internet HTTP/HTTPS | Nginx |
| Nginx + WAF | Nginx + ModSecurity |
| Configuration versionnée / GitOps | Nginx |
| TCP / Stream | HAProxy |
| Docker / services dynamiques | Traefik |
| Frontal interne | Nginx |
| Load Balancing Exchange | IIS + ARR |
| Kubernetes | Selon le contexte |
Il n’y a donc pas réellement de gagnant dans cette histoire.
Un reverse proxy peut être excellent dans un contexte et beaucoup moins adapté dans un autre.
C’est d’ailleurs probablement la principale leçon que je retiens après plusieurs années à gérer ces infrastructures.
Le bon outil n’est pas forcément celui qui possède le plus de fonctionnalités. C’est celui qui répond correctement au besoin tout en restant exploitable par l’équipe qui devra le maintenir.
Et avec plusieurs dizaines d’applications derrière les reverse proxy, ce dernier point devient rapidement aussi important que les performances ou les fonctionnalités.
Au final, plutôt que de chercher à tout faire avec une seule solution, je préfère avoir plusieurs outils maîtrisés et les utiliser là où ils ont du sens.
Bienvenue dans la jungle des reverse proxy.